AI에게 거부당해 본 적 있다면, 이제 그 이유를 문서로 읽을 수 있어요
AI를 쓰다 보면 한 번쯤 겪어요. 별생각 없이 던진 요청이 “도와드릴 수 없습니다”로 돌아오는 순간요. 지금까지 그 기준은 사용자에게 블랙박스였어요 — 뭐가 되고 뭐가 안 되는지, 왜 안 되는지 알 방법이 없었죠. 7월 2일 Anthropic이 Fable 5의 cyber safeguards가 실제로 어떻게 작동하는지, 그리고 그게 뚫렸을 때 심각도를 어떻게 매기는지를 공개했어요. 재배포 바로 다음 날 나온, 일종의 설계도 공개입니다.
무슨 일이 있었나
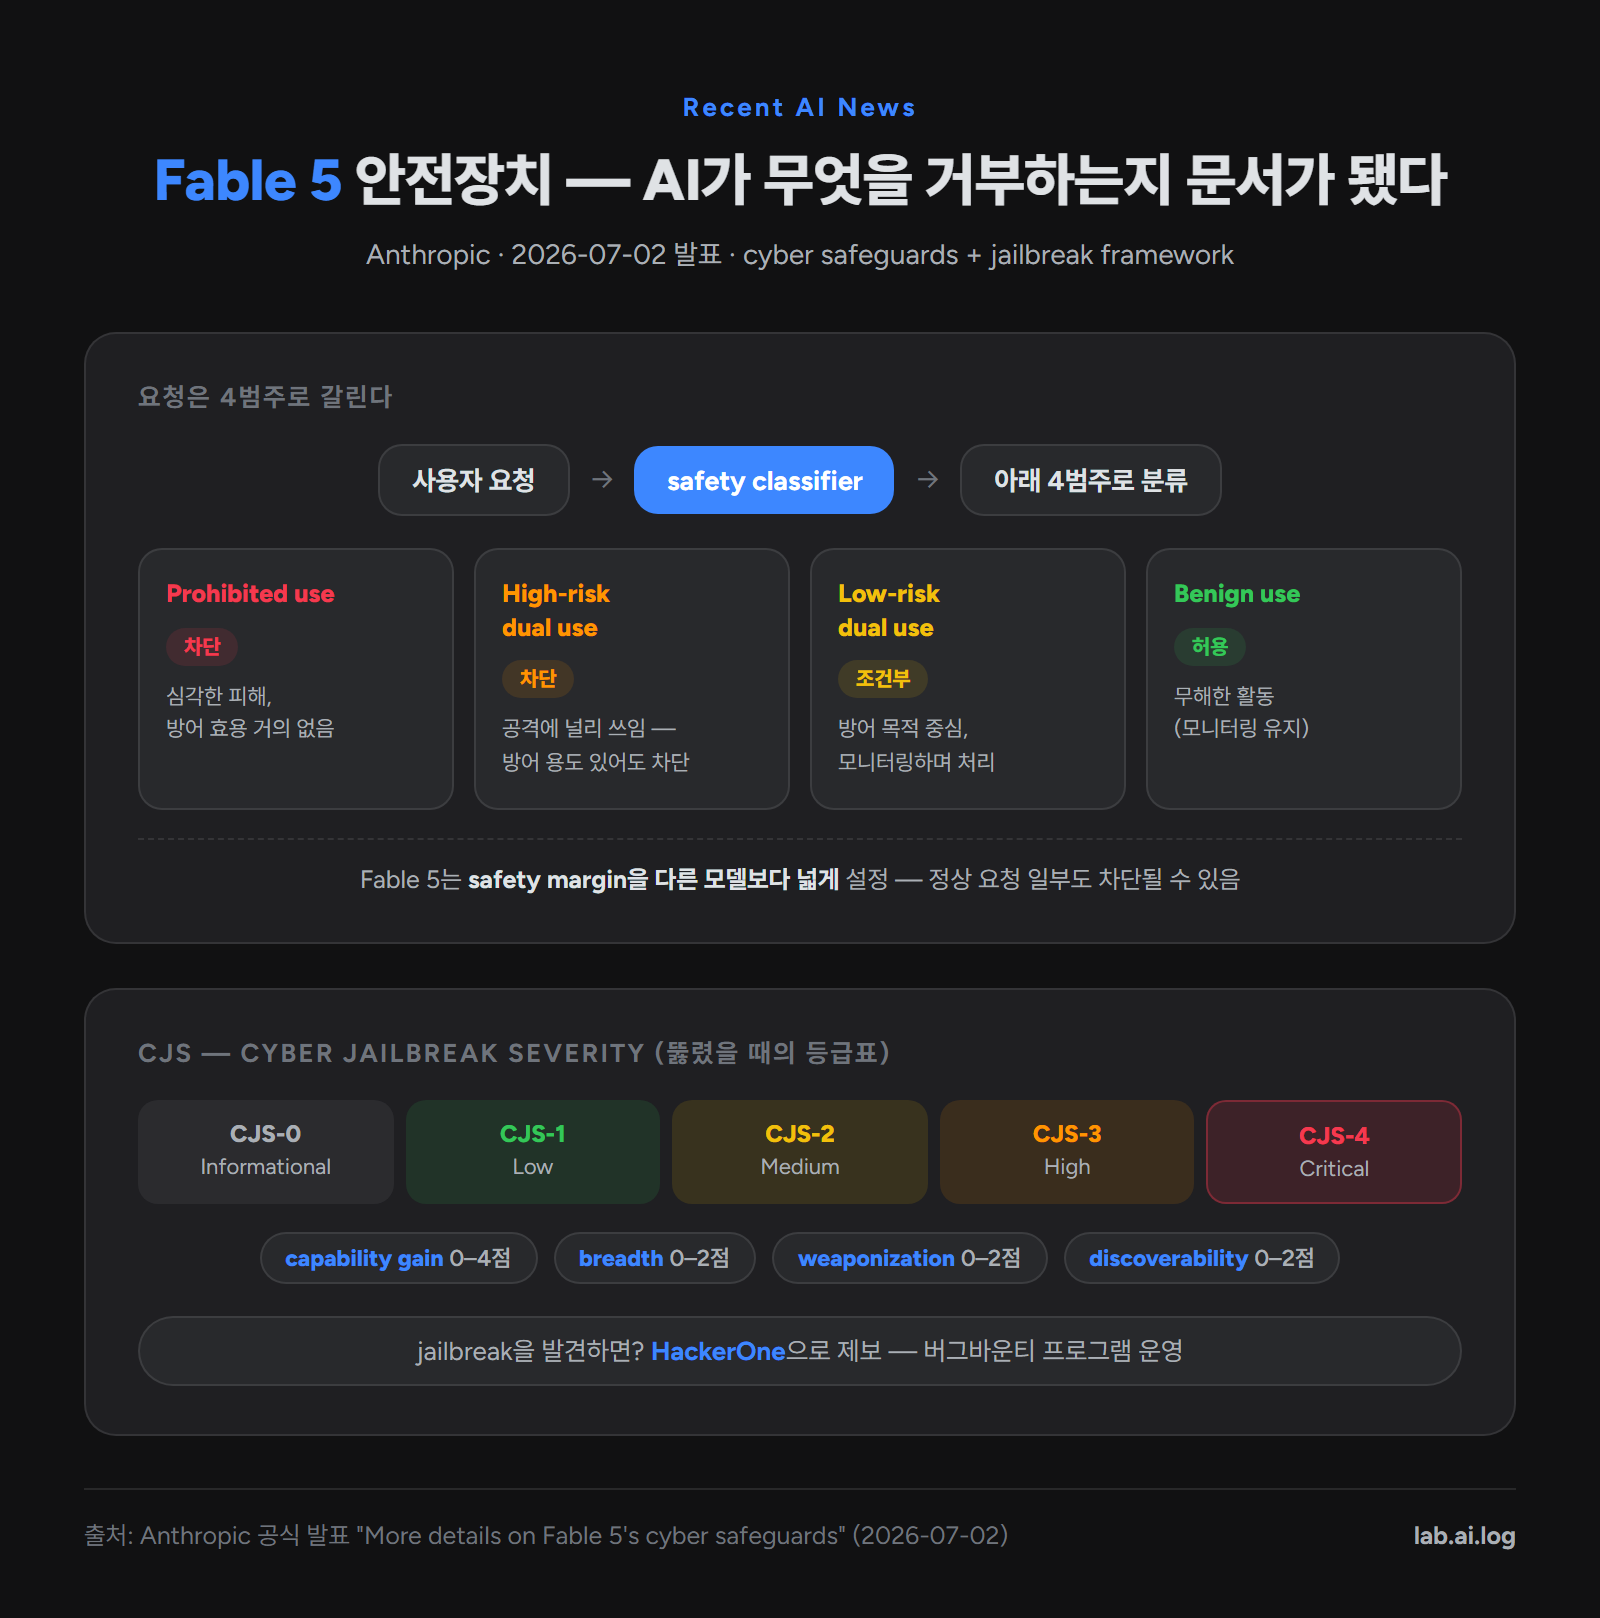
용어부터 하나 짚을게요. jailbreak은 모델의 안전장치를 우회해서, 원래라면 거부해야 할 출력을 끌어내는 기법을 말해요. 이번 발표는 그 방어 체계와, 방어가 뚫렸을 때의 평가 체계를 다룹니다.
요청은 4범주로 갈려요. Fable 5 앞단에는 safety classifier(들어오는 요청이 위험한지 판별하는 별도 모델)가 있는데, 사이버 영역 요청을 네 범주로 분류해요.
- Prohibited use — 심각한 피해를 일으키고 방어적 효용은 거의 없는 요청. 차단해요.
- High-risk dual use — 공격자들이 광범위하게 쓰는 능력. 방어 용도가 있어도 차단합니다.
- Low-risk dual use — 방어 목적이 중심이지만 악용될 수도 있는 요청. 모니터링하면서 조건부로 처리해요.
- Benign use — 무해한 활동. 허용하되 모니터링은 유지합니다.
여기에 하나 더 — Fable 5는 이 분류의 safety margin을 다른 모델보다 넓게 잡았어요. 경계선에 걸친 요청이면 차단 쪽으로 기운다는 뜻이고, 그래서 정상적인 요청 일부가 같이 차단될 수 있다는 것도 명시돼 있어요.
뚫렸을 때의 등급표, CJS. 발표의 두 번째 축은 CJS(Cyber Jailbreak Severity)라는 프레임워크예요. 소프트웨어 보안에는 취약점의 심각도를 0–10점으로 매기는 CVSS라는 산업 표준이 있는데요, CJS는 CVSS의 AI jailbreak 버전이라고 보면 이해가 빨라요(이 비유는 제 해석이에요). 발견된 jailbreak을 네 가지 축으로 점수 매깁니다.
- Capability gain (0–4점) — 기존에 구할 수 있는 도구보다 얼마나 더 강한 능력을 주는가
- Breadth (0–2점) — 그 능력이 얼마나 넓은 범위에 적용되는가
- Ease of weaponization (0–2점) — 실제 공격으로 바꾸기가 얼마나 쉬운가
- Discoverability (0–2점) — 그 기법을 얼마나 쉽게 찾아낼 수 있는가
합산 점수에 따라 CJS-0(정보성)부터 CJS-4(Critical)까지 5단계가 매겨져요. 스케일은 로그 방식이라 한 단계 올라갈 때마다 수 배씩 심각해지고요. 최종 등급은 계산값보다 올릴 수는 있어도 내릴 수는 없게 돼 있어요.
제보 채널도 열렸어요. 보안 연구자가 Fable 5에서 jailbreak을 발견하면 HackerOne(보안 취약점 신고·보상 플랫폼)으로 제보할 수 있는 프로그램이 함께 시작됐어요.
한계도 스스로 적었어요. 이 프레임워크는 “early draft”이고, classifier는 피드백에 따라 계속 바뀔 수 있대요. 그리고 무엇보다 — “모든 보안 능력은 dual use다”. 공격자에게 유용한 능력은 방어자에게도 유용하다는 딜레마를 정면으로 인정하고, 그 위에서 선을 긋는 기준을 공개한 겁니다.
왜 중요한가
안전장치가 블랙박스 밖으로 나왔어요. 지금까지 “AI가 이건 왜 거부하지?”라는 질문의 답은 추측의 영역이었어요. 이제 적어도 사이버 영역에서는 4범주 기준표가 있습니다. 내 요청이 어디에 해당하는지 가늠할 수 있고, 이상한 차단을 만나면 “margin을 넓게 잡은 설계의 대가”라고 해석할 근거가 생겼어요. 도구의 거동을 예측할 수 있게 해주는 문서 — 사용자에게 이보다 실용적인 투명성은 없어요.
심각도 등급을 표준화하려는 시도이기도 해요. CVSS가 나오기 전에는 소프트웨어 취약점의 심각성을 회사마다 제각각으로 말했어요. 지금 AI jailbreak이 딱 그 상태거든요 — 누가 “치명적 탈옥 발견”이라고 해도 얼마나 심각한지 비교할 공통 언어가 없어요. CJS는 Glasswing 파트너들(Amazon, Microsoft, Google 등)과 함께 만든 초안이고, 정부·산업과 일관되게 소통하려는 목적이 명시돼 있어요. 표준이 되면 AI 안전 사고 소식을 지금보다 훨씬 정확하게 읽고 비교할 수 있게 될 거예요.
“AI jailbreak 제보”가 직업의 영역으로 들어왔어요. HackerOne 프로그램은 상징적이에요. jailbreak을 찾는 행위가 음지의 놀이가 아니라, 등급표에 따라 평가받고 보상받는 보안 리서치가 된 거죠. 보안 커리어를 생각하는 분에게는 새 전문 분야가 하나 열리는 장면이기도 합니다.
My Take
이 발표를 읽고 나서 제 쪽에서 바뀐 건 하나예요 — 차단을 버그가 아니라 문서화된 설계로 읽게 됐다는 것.
실무에서 이건 생각보다 유용한 관점 전환이에요. AI가 정당한 요청을 거부하면 보통 짜증부터 나잖아요. 그런데 4범주 표를 알고 나면 내 요청이 왜 low-risk dual use 언저리로 분류됐을지 짐작할 수 있어요. 그리고 이 설계에서 자연스럽게 따라 나오는 실용 원칙이 있습니다 — 정당한 목적이라면 맥락을 숨기지 말고 밝히는 것. 방어 목적의 보안 질문이나 연구 목적의 분석이라면 그 의도를 요청에 그대로 쓰는 편이 이 분류 체계와 맞물려요. 발표문도 정당한 사례와 해로운 사례를 가르는 건 결국 맥락(context)이라고 못 박고 있거든요.
하나 더요. dual use 딜레마를 “인정한다”고 쓴 대목은 기억해 둘 가치가 있어요. 안전장치는 완벽한 선긋기가 아니라 오차를 감수한 트레이드오프이고, 그 오차의 방향(의심스러우면 차단)을 회사가 명시적으로 선택했다는 거예요. 앞으로 다른 회사 모델을 평가할 때도 같은 질문을 던지게 될 것 같아요 — 이 모델은 어느 쪽으로 틀리도록 설계됐고, 그걸 문서로 공개하고 있는가. 저는 이 질문을 AI 도구를 고르는 새 기준으로 삼으려 해요.
댓글Comments