프론티어 모델 출시의 첫 관문이 벤치마크가 아니라 워싱턴이 됐어요
한 주 사이에 두 번째예요. Anthropic의 Fable 5가 수출통제를 거쳐 돌아온 바로 그 주에, OpenAI는 차세대 모델 GPT-5.6을 발표하면서 일반 공개 대신 “미국 정부의 요청에 따라” 소수 파트너에게만 여는 길을 택했어요. 신모델 발표라면 늘 벤치마크 점수나 데모 영상부터 봤는데요, 이번엔 그보다 먼저 정부 협의라는 절차가 있었습니다.
무슨 일이 있었나
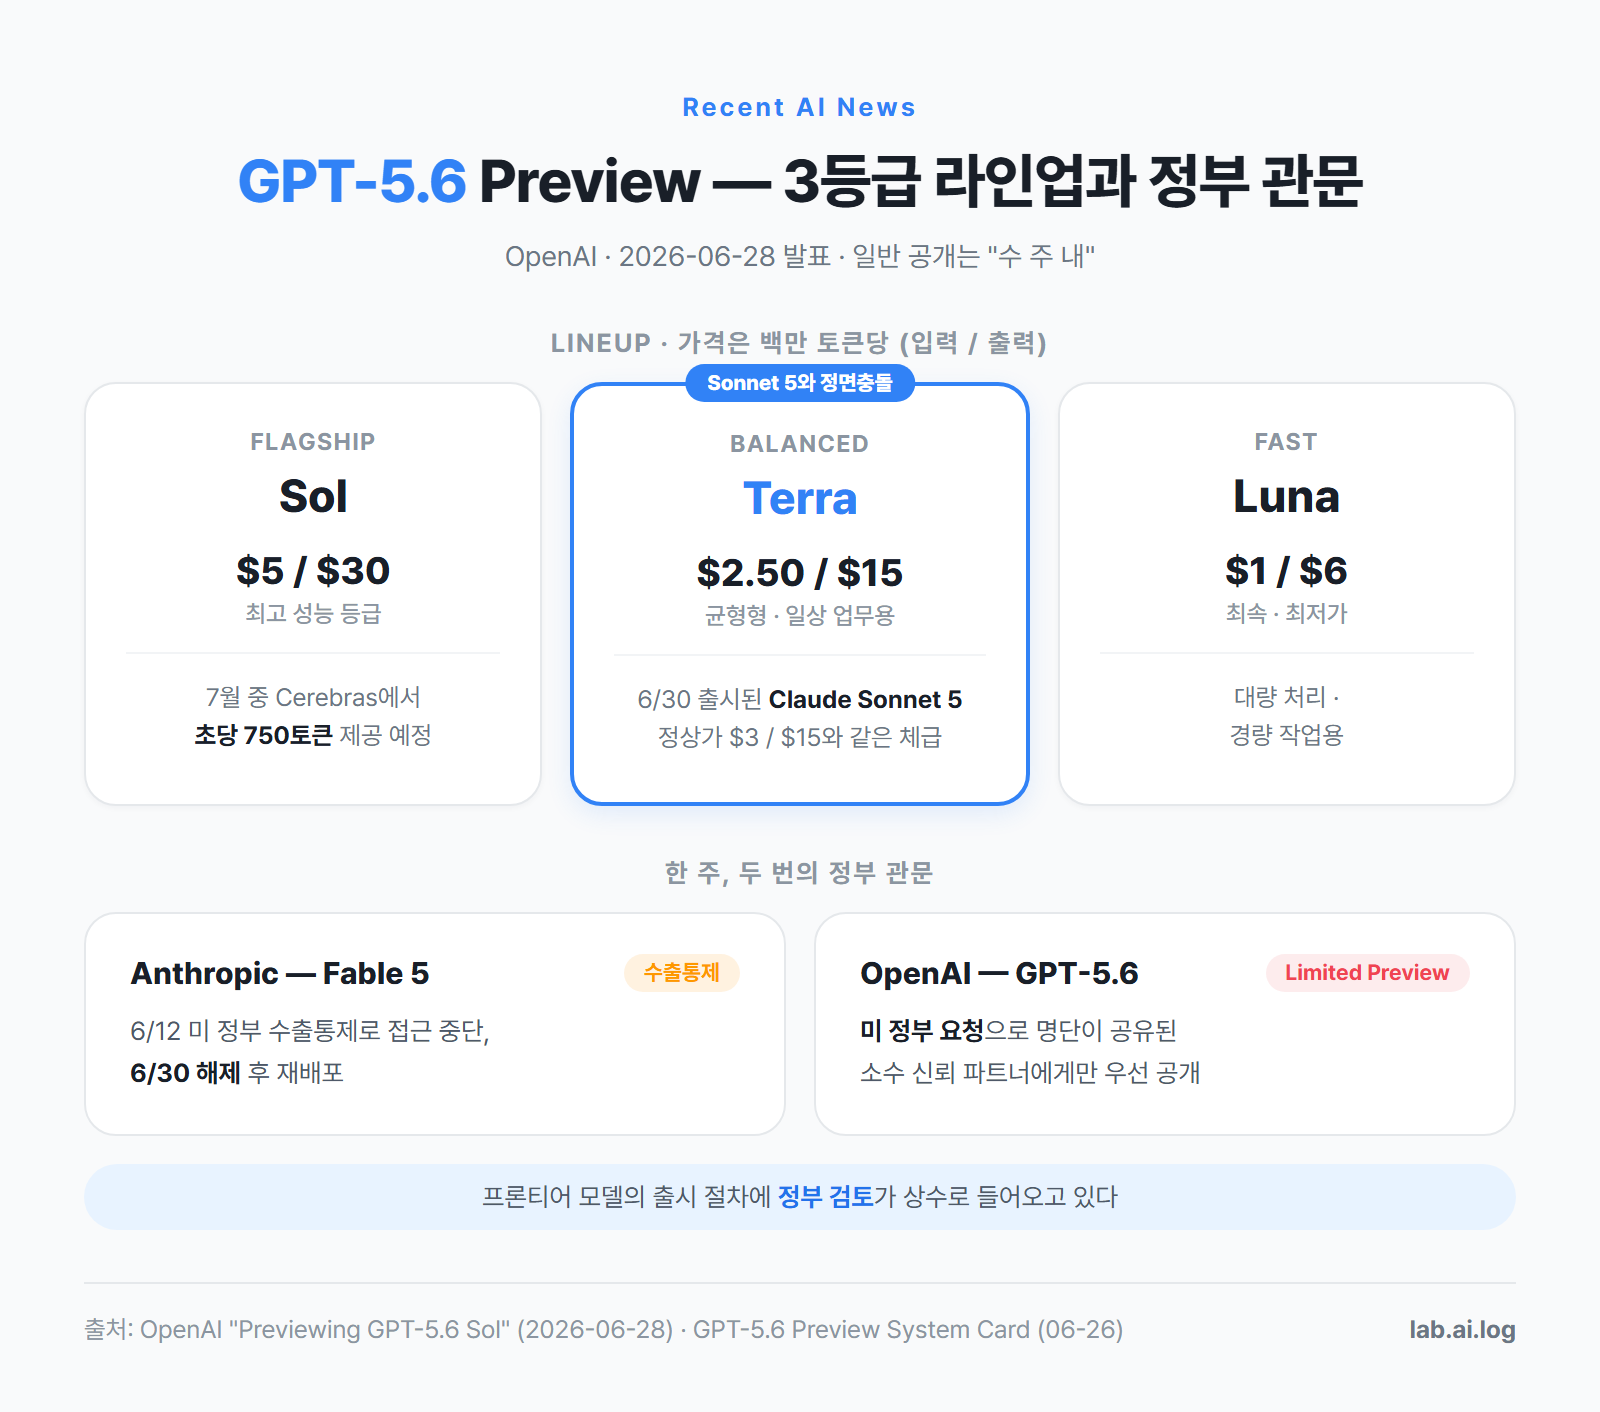
OpenAI가 6월 28일 GPT-5.6 패밀리를 발표했어요. 안전 평가를 담은 system card는 이틀 전인 26일에 먼저 올라왔고요.
라인업은 세 등급이에요. 플래그십 Sol, 균형형 Terra, 최속·최저가 Luna. 가격은 백만 토큰당 Sol $5/$30, Terra $2.50/$15, Luna $1/$6(입력/출력)입니다. 어디서 본 구조 같지 않나요? Anthropic의 Opus·Sonnet·Haiku와 같은 3단 구성이고, 심지어 균형 등급의 가격대까지 겹쳐요. 이틀 뒤 나온 Claude Sonnet 5의 정상가가 $3/$15거든요.
이번 발표의 진짜 뉴스는 공개 방식이에요. system card를 보면, OpenAI는 “미국 정부와의 지속적 협의의 일환으로” 출시 전에 계획과 모델 능력을 공유했고, “정부의 요청에 따라” 소수 신뢰 파트너에게만 limited preview를 열었는데, 그 참여 명단도 정부와 공유됐어요. 외신 보도로는 약 20개 기관이고 명단은 비공개예요. ChatGPT·Codex·API를 통한 일반 공개는 “수 주 내”라고만 밝혔습니다.
정부가 왜 끼어들까요? system card의 안전 평가를 보면 감이 와요. 세 모델 모두 사이버보안과 생물·화학 영역에서 “High” 등급(OpenAI의 위험 분류에서 실질적 피해 가능성을 따져야 하는 수준)을 받았거든요. 한계도 같이 적혀 있어요. Sol과 Terra는 소프트웨어 취약점을 찾아낼 수는 있지만, 방어가 강화된 시스템을 상대로 한 자율적인 end-to-end 공격에는 실패했다고요. 이런 능력 평가가 정부와 사전 공유되고, 그 결과에 따라 공개 범위가 조정되는 것 — 이게 이번에 확인된 새 절차예요.
개발자 입장에서 제일 실속 있는 변화는 prompt caching 개선이에요. prompt caching은 반복 사용하는 컨텍스트(시스템 프롬프트, 참고 문서 같은 것들)를 서버에 캐시해 두고, 재사용할 때 할인해 주는 기능인데요. 이번에 캐시를 어디서 끊을지 지정하는 명시적 breakpoint와 최소 30분의 캐시 수명이 들어왔어요. 캐시 쓰기는 입력 단가의 1.25배, 읽기는 90% 할인이고요. 지금까지는 캐시가 언제 사라질지 예측하기 어려워서 설계가 곤란했는데, 30분 보장이 생기면 에이전트 설계의 계산이 달라집니다.
속도 이야기도 있어요. 플래그십 Sol이 7월 중 Cerebras에서 최대 초당 750토큰으로 제공될 예정이에요(초기 일부 고객). Cerebras는 웨이퍼 한 장을 통째로 칩으로 쓰는 추론 전용 하드웨어 회사인데, 일반적인 GPU 서빙보다 몇 배 빠릅니다. 프론티어급 모델의 응답 대기가 사실상 사라지는 수준이에요.
왜 중요한가
정부 검토가 출시 절차의 상수가 됐어요. 6월 한 달 동안 Anthropic은 수출통제로 모델을 내렸다 올렸고, OpenAI는 정부 요청으로 공개 범위를 좁혔어요. 서로 다른 회사가 서로 다른 형태로 같은 관문을 통과한 거죠. 사용자 입장에서 생기는 새 변수는 이겁니다 — “기술적으로 완성된 모델”과 “내가 쓸 수 있는 모델” 사이의 시차. 발표를 봤다고 바로 쓸 수 있는 시대가 아니게 됐어요.
두 회사의 라인업이 같은 모양으로 수렴하고 있어요. 플래그십–균형–경량 3등급에 겹치는 가격대까지. 모델 선택이 점점 “어느 회사 팬인가”가 아니라 “이 작업에 어느 등급이 맞는가”의 문제가 된다는 뜻이에요. 한쪽 생태계에만 익숙해지기보다 등급 개념으로 사고하는 습관이 앞으로 더 쓸모 있어질 거예요.
비용 최적화의 무게중심이 캐싱으로 이동해요. 모델 단가는 계속 내려가는 추세라 절대 단가 차이는 줄어들거든요. 반면 같은 컨텍스트를 하루에 수백 번 재사용하는 에이전트형 워크로드에서는 캐시 적중률이 청구액을 몇 배 단위로 갈라요. 단가표 비교보다 캐시 설계가 먼저인 시대가 오고 있습니다.
My Take
이번 발표에서 제일 오래 기억될 대목은 가격표가 아니라 출시 절차라고 생각해요. 프론티어 AI가 전략 자산으로 다뤄지는 시대에는 “언제 출시되는가”가 연구 로드맵이 아니라 규제 일정의 함수가 되거든요. 새 모델 소식을 볼 때 체크할 항목이 하나 늘었어요 — 발표일이 아니라 “내 손에 오는 날”을 확인하는 것.
실무 쪽 조언은 캐싱에 집중됩니다. prompt caching이 30분 보장 + 명시적 breakpoint로 바뀌면 프롬프트를 짜는 방식 자체를 바꿀 수 있어요. 원칙은 간단해요 — 바뀌지 않는 부분(시스템 프롬프트, 참고 문서, 예시)을 앞에, 매번 바뀌는 부분(사용자 질문)을 뒤에 배치하고 그 경계에 breakpoint를 두는 겁니다. 캐시는 앞에서부터 일치하는 만큼만 적중하거든요. 이건 GPT-5.6만의 이야기가 아니라 캐싱을 지원하는 모든 모델(Claude 포함)에서 통하는, 지금 바로 적용할 수 있는 습관이에요.
Sol이냐 Terra냐 같은 등급 고민은 일반 공개가 열린 뒤에 해도 늦지 않아요. 그때 가장 먼저 볼 건 벤치마크 순위가 아니라 내 반복 워크로드에서 나오는 실효 단가, 즉 캐시 적중률이 반영된 청구액입니다.
댓글Comments